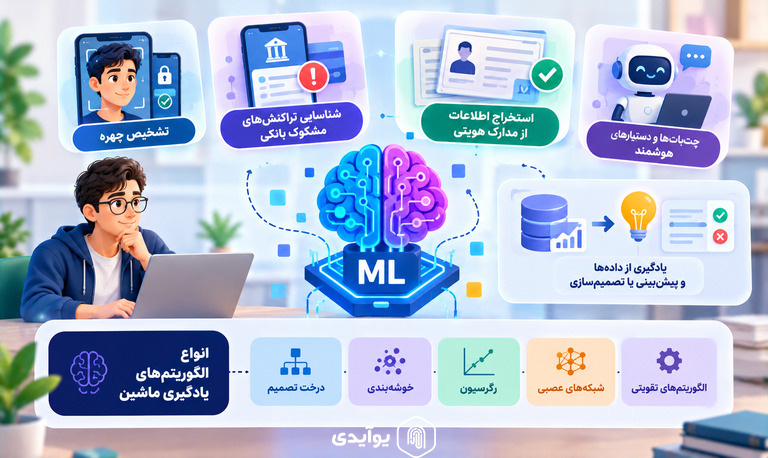
از تشخیص چهره در تلفن همراه گرفته تا شناسایی تراکنشهای مشکوک بانکی و استخراج اطلاعات از مدارک هویتی، بسیاری از فناوریهای امروزی از الگوریتم های یادگیری ماشین برای تحلیل دادهها و شناسایی الگوها استفاده میکنند. این الگوریتمها به سیستمها کمک میکنند بدون تعریف دستی تمام قواعد، از دادهها یاد بگیرند و برای دادههای جدید پیشبینی یا تصمیمسازی کنند. اما همه الگوریتمها روش یادگیری یکسانی ندارند و هرکدام برای نوع خاصی از مسئله مناسباند.
در این مقاله، با انواع الگوریتم های یادگیری ماشین، تفاوت آنها، کاربردهایشان در دادهکاوی و فناوریهای هویتی، معیارهای ارزیابی و روش انتخاب الگوریتم مناسب آشنا میشوید.
الگوریتم های یادگیری ماشین چیست؟
الگوریتم یادگیری ماشین یا Machine Learning Algorithm مجموعهای از روشها و قواعد محاسباتی است که با استفاده از دادهها، الگوها و روابط آماری را یاد میگیرد تا یک مسئله مشخص را حل کند. خروجی این فرایند میتواند پیشبینی یک مقدار، دستهبندی اطلاعات، شناسایی الگوهای پنهان یا تشخیص رفتارهای غیرعادی باشد.
تفاوت الگوریتم یادگیری ماشین، مدل و داده چیست؟
برای درک درست این فناوری، باید سه مفهوم را از یکدیگر تفکیک کنیم:
- داده (Data) : اطلاعاتی که سیستم از آنها برای یادگیری استفاده میکند؛ مانند تصاویر چهره، سوابق تراکنشها یا اطلاعات مربوط به مشتریان.
- الگوریتم (Algorithm) : روش محاسباتی که از دادهها برای یادگیری الگوها یا تنظیم پارامترها استفاده میکند.
- مدل (Model) : نتیجه آموزش الگوریتم که میتواند روی دادههای جدید پیشبینی انجام دهد.
برای مثال، فرض کنید میخواهیم مدلی برای تشخیص تراکنشهای مشکوک بسازیم. دادههای تراکنشهای گذشته، ورودی فرایند آموزش هستند. الگوریتمی مانند جنگل تصادفی (Random Forest) الگوهای مرتبط با تراکنشهای مشکوک را یاد میگیرد و مدل آموزشدیده، تراکنشهای جدید را ارزیابی میکند.
به زبان ساده، الگوریتم روش یادگیری است و مدل حاصل یادگیری آن روش از دادههاست.
الگوریتم های ماشین لرنینگ چگونه یاد میگیرند؟
یادگیری ماشین بر این ایده استوار است که بهجای نوشتن تمام قواعد بهصورت دستی، از نمونههای داده برای یافتن رابطه میان ورودیها و خروجیها استفاده کنیم.
یک فرایند ساده یادگیری ماشین معمولاً شامل مراحل زیر است:
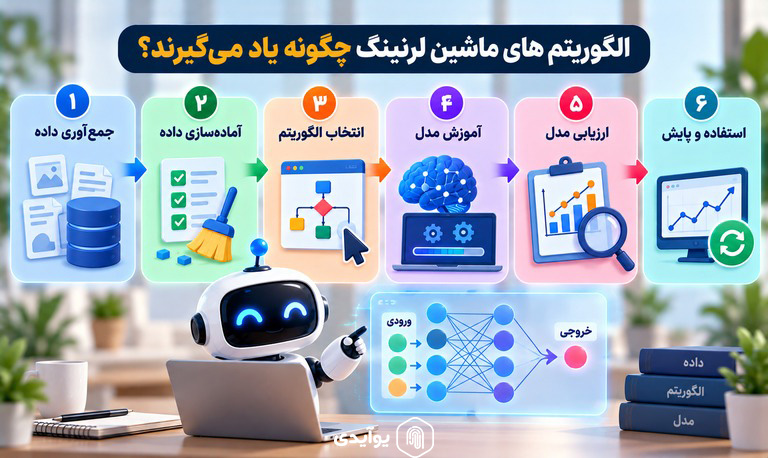
- جمعآوری داده: اطلاعات مرتبط با مسئله تهیه میشوند.
- آمادهسازی داده: خطاها، دادههای تکراری، مقادیر گمشده و ناسازگاریهای احتمالی بررسی میشوند.
- انتخاب الگوریتم: متناسب با هدف، نوع داده و محدودیتهای مسئله، یک الگوریتم انتخاب میشود.
- آموزش مدل: الگوریتم با استفاده از دادههای آموزشی، پارامترهای مدل را تنظیم میکند.
- ارزیابی مدل: عملکرد مدل روی دادههایی که برای آموزش استفاده نشدهاند بررسی میشود.
- استفاده و پایش: مدل در محیط واقعی به کار گرفته میشود و عملکرد آن در طول زمان زیر نظر قرار میگیرد.
برای آشنایی بیشتر با اصول پایه این فناوری، مطالعه مطلب ماشین لرنینگ چیست میتواند به درک بهتر ارتباط میان الگوریتم، مدل و فرایند یادگیری کمک کند.
تفاوت هوش مصنوعی، یادگیری ماشین و یادگیری عمیق چیست؟
این سه مفهوم ارتباط نزدیکی با یکدیگر دارند، اما مترادف نیستند. شناخت تفاوت آنها کمک میکند هنگام بررسی فناوریها، ابزار مناسبتری انتخاب کنید.
هوش مصنوعی (AI)
مجموعه گستردهای از روشها برای ساخت سیستمهایی که وظایف مرتبط با استدلال، پیشبینی، ادراک، برنامهریزی یا تولید محتوا را انجام میدهند.
بیشتر بخوانید: هوش مصنوعی یا AI چیست و چه کاربردهایی دارد؟
یادگیری ماشین (ML)
یکی از شاخههای هوش مصنوعی که در آن سیستم از دادهها الگو میآموزد تا پیشبینی یا تحلیل انجام دهد.
یادگیری عمیق (Deep Learning)
زیرمجموعهای از یادگیری ماشین که از شبکههای عصبی چندلایه برای یادگیری الگوهای پیچیده استفاده میکند.
هوش مصنوعی یا AI چیست و چه ارتباطی با الگوریتمهای ML دارد؟
هوش مصنوعی حوزهای گستردهتر از یادگیری ماشین است. برخی سیستمهای هوش مصنوعی با قواعد از پیش تعریفشده و روشهای جستوجو یا استدلال کار میکنند و لزوماً به یادگیری از داده نیاز ندارند.
در مقابل، الگوریتمهای یادگیری ماشین با استفاده از دادهها، روابطی را یاد میگیرند که برای پیشبینی یا تصمیمسازی به کار میروند. بنابراین، هر سیستم یادگیری ماشین در حوزه هوش مصنوعی قرار میگیرد، اما هر سیستم هوش مصنوعی الزاماً از یادگیری ماشین استفاده نمیکند.
برای شناخت بهتر سیر تحول این مفاهیم، میتوانید مطلب تاریخچه هوش مصنوعی را نیز مطالعه کنید.
دیپ لرنینگ یا یادگیری عمیق چه تفاوتی با یادگیری ماشین دارد؟
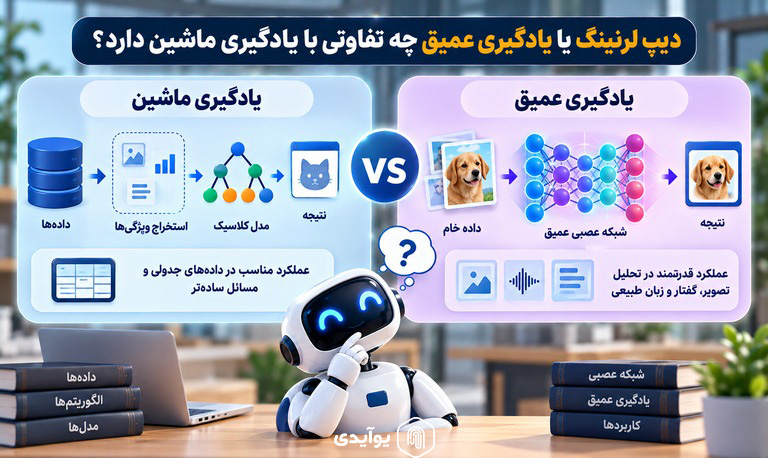
یادگیری عمیق از شبکههای عصبی با چندین لایه پردازشی استفاده میکند تا بازنماییهای پیچیدهتری از دادهها بیاموزد. این روش در مسائلی مانند تحلیل تصویر، پردازش گفتار و زبان طبیعی کاربرد زیادی دارد.
برای مثال، یک الگوریتم کلاسیک ممکن است برای تشخیص یک شیء به مجموعهای از ویژگیهای از پیش استخراجشده نیاز داشته باشد؛ درحالیکه شبکه عصبی عمیق میتواند بخشی از ویژگیهای مناسب را مستقیماً از داده خام یاد بگیرد.
با این حال، یادگیری عمیق همیشه بهترین انتخاب نیست. برای دادههای جدولی کوچک، مدلهایی مانند درخت تصمیم یا الگوریتمهای مبتنی بر گرادیان ممکن است عملکرد مناسبتری داشته باشند یا سادهتر آموزش داده شوند.
برای بررسی تخصصیتر این موضوع، مقاله دیپ لرنینگ یا یادگیری عمیق چیست میتواند مسیر مطالعه تکمیلی باشد.
انواع الگوریتم های یادگیری ماشین کداماند؟
یکی از رایجترین روشهای دستهبندی الگوریتمهای یادگیری ماشین، بررسی نحوه یادگیری آنهاست. بر این اساس، رویکردهای یادگیری نظارتشده، بدون نظارت، نیمهنظارتی، خودنظارتی و تقویتی از مهمترین دستهها هستند. هر رویکرد به نوع متفاوتی از داده و بازخورد نیاز دارد.
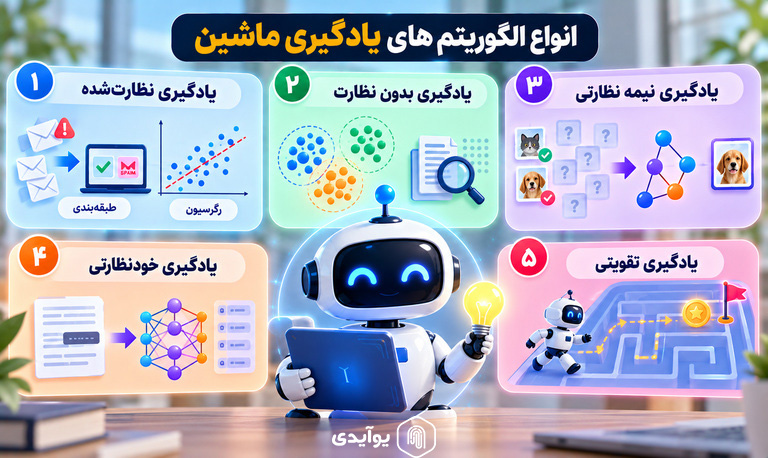
۱. الگوریتمهای یادگیری نظارت شده (Supervised Learning)
در یادگیری نظارتشده، مدل از دادههایی آموزش میبیند که برای آنها پاسخ یا برچسب مشخص وجود دارد. برای مثال، اگر مجموعهای از تراکنشهای بانکی با برچسب «عادی» یا «مشکوک» داشته باشیم، مدل میتواند رابطه میان ویژگیهای تراکنش و برچسب آن را یاد بگیرد.
این رویکرد معمولاً برای دو نوع مسئله استفاده میشود:
- طبقهبندی (Classification) : پیشبینی یک گروه یا برچسب؛ مانند تشخیص ایمیل ناخواسته یا دستهبندی تراکنشها.
- رگرسیون (Regression) : پیشبینی یک مقدار عددی؛ مانند برآورد قیمت، زمان یا میزان تقاضا.
الگوریتمهای نظارتشده زمانی مفیدند که نمونههای آموزشی باکیفیت و پاسخهای معتبر در اختیار داشته باشیم.
۲. الگوریتمهای یادگیری بدون نظارت (Unsupervised Learning)
در یادگیری بدون نظارت، دادههای آموزشی الزاماً برچسب از پیش تعیینشده ندارند. هدف، کشف ساختارها، شباهتها یا الگوهایی است که در دادهها وجود دارند.
یکی از کاربردهای شناختهشده این رویکرد، خوشهبندی (Clustering) است؛ یعنی گروهبندی نمونههای مشابه بدون اینکه برچسب نهایی هر گروه از ابتدا مشخص شده باشد.
برای مثال، یک فروشگاه اینترنتی ممکن است با تحلیل رفتار خرید مشتریان، گروههایی از کاربران با الگوهای خرید مشابه پیدا کند. پس از شناسایی این گروهها، تیم کسبوکار میتواند برای هر گروه راهبرد بازاریابی مناسبتری طراحی کند.
یادگیری بدون نظارت همچنین در شناسایی ناهنجاریها، کاهش ابعاد داده و بررسی ساختار مجموعهدادهها کاربرد دارد.
۳. یادگیری نیمه نظارتی (Semi-Supervised Learning)
در یادگیری نیمهنظارتی، بخشی از دادهها برچسبگذاری شدهاند و بخش بزرگتری از دادهها بدون برچسب هستند. هدف این است که مدل از اطلاعات هر دو گروه استفاده کند.
این رویکرد برای شرایطی مناسب است که تهیه برچسب دقیق هزینهبر باشد؛ برای مثال، در مجموعه بزرگی از تصاویر مدارک هویتی که فقط بخشی از آنها بهصورت تخصصی برچسبگذاری شدهاند.
البته وجود داده بدون برچسب بهتنهایی کیفیت مدل را تضمین نمیکند. اگر دادههای برچسبدار نماینده مناسبی از مسئله نباشند یا دادههای بدون برچسب با هدف مدل سازگار نباشند، نتیجه ممکن است مطلوب نباشد.
۴. یادگیری خود نظارتی (Self-Supervised Learning)
در یادگیری خودنظارتی، سیستم از ساختار خود دادهها برای تولید یک وظیفه آموزشی استفاده میکند و بدون نیاز به برچسبگذاری دستی برای تکتک نمونهها، بازنماییهای مفیدی از داده میآموزد.
برای نمونه، یک مدل زبانی میتواند با پیشبینی بخش پنهانشده یا بخش بعدی یک متن آموزش ببیند. مدلهای تصویری نیز ممکن است با یادگیری ارتباط میان بخشهای یک تصویر یا نماهای متفاوت از یک نمونه آموزش داده شوند.
یادگیری خودنظارتی در آموزش مدلهای بزرگ زبان و تصویر نقش مهمی دارد، اما معمولاً بهعنوان جایگزینی قطعی برای تمام مراحل یادگیری نظارتشده مطرح نیست؛ مدل ممکن است برای یک کاربرد مشخص همچنان به تنظیم دقیق یا ارزیابی تخصصی نیاز داشته باشد.
۵. یادگیری تقویتی (Reinforcement Learning)
در یادگیری تقویتی، یک عامل (Agent) در محیطی مشخص اقداماتی انجام میدهد و بر اساس نتیجه آنها پاداش یا جریمه دریافت میکند. هدف، یادگیری راهبردی است که در بلندمدت مجموع پاداشها را بهبود دهد.
از این رویکرد در آموزش عاملهای بازی، کنترل رباتها و برخی مسائل تصمیمگیری متوالی استفاده میشود.
برای مثال، یک عامل نرمافزاری ممکن است در محیط شبیهسازیشده یاد بگیرد چگونه میان چند اقدام ممکن انتخاب کند. کیفیت چنین روشی به طراحی محیط، تعریف پاداش و میزان شباهت شبیهسازی با شرایط واقعی بستگی دارد.
نکته مهم این است که یادگیری تقویتی مانند یادگیری نظارتشده صرفاً از مجموعهای از ورودیها و پاسخهای صحیح آماده یاد نمیگیرد؛ بلکه از پیامد اقدامها و بازخورد محیط استفاده میکند.
انواع الگوریتم های یادگیری ماشین بر اساس نوع مسئله
روش دیگر دستهبندی، توجه به کاری است که الگوریتم انجام میدهد. برای انتخاب الگوریتم مناسب، ابتدا باید مسئله را دقیق تعریف کنیم؛ زیرا حتی دو مدل با نام مشابه ممکن است برای هدفهای متفاوتی استفاده شوند.
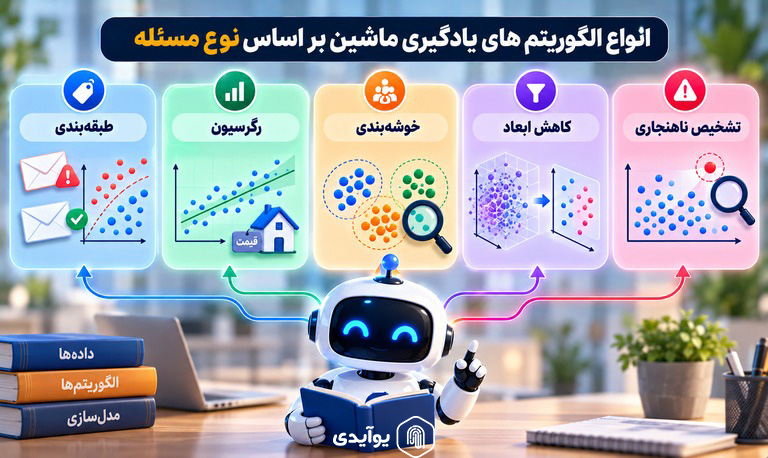
الگوریتمهای طبقهبندی (Classification)
طبقهبندی زمانی استفاده میشود که خروجی مدل باید یک دسته یا کلاس مشخص باشد. نمونههایی از آن عبارتاند از تشخیص هرزنامه، دستهبندی نوع سند و شناسایی درخواستهای پرریسک.
رگرسیون لجستیک با وجود واژه «رگرسیون» در نامش، معمولاً برای طبقهبندی استفاده میشود. این الگوریتم میتواند احتمال تعلق یک نمونه به کلاس را برآورد کند و سپس با توجه به آستانه تعیینشده، خروجی طبقهبندی را مشخص کند.
درخت تصمیم با مجموعهای از تقسیمبندیهای متوالی، مسیر رسیدن به پیشبینی را ایجاد میکند. ساختار آن معمولاً قابل فهمتر از بسیاری از مدلهای پیچیده است، اما در صورت کنترلنشدن پیچیدگی میتواند بیشازحد به دادههای آموزشی وابسته شود.
جنگل تصادفی از مجموعهای از درختهای تصمیم استفاده میکند و خروجی آنها را ترکیب میکند. این ترکیب در بسیاری از مسائل میتواند پایداری و کیفیت پیشبینی را بهبود دهد، هرچند تضمینی برای برتری آن در همه مسائل وجود ندارد.
ماشین بردار پشتیبان (SVM) به دنبال مرزی برای جدا کردن گروههاست و با استفاده از هستههای مناسب میتواند الگوهای غیرخطی را نیز مدلسازی کند. عملکرد آن به انتخاب تنظیمات، مقیاس ویژگیها و نوع داده وابسته است.
الگوریتمهای رگرسیون (Regression)
اگر هدف پیشبینی یک مقدار پیوسته باشد، ممکن است از رگرسیون استفاده کنیم. برای مثال، پیشبینی تقاضای روزانه یا تخمین مدت زمان انجام یک فرایند، مسئله رگرسیون است.
رگرسیون خطی رابطهای خطی میان ویژگیها و مقدار هدف یاد میگیرد. این روش ساده و قابل تفسیر است؛ اما هنگامی که رابطه واقعی پیچیده یا غیرخطی باشد، ممکن است بهتنهایی کافی نباشد.
مدلهای درختی و روشهای تقویتی نیز میتوانند برای رگرسیون به کار روند؛ بهویژه در دادههای جدولی که رابطه میان ویژگیها ساده و خطی نیست.
الگوریتمهای خوشهبندی (Clustering)
خوشهبندی برای تقسیم دادهها به گروههایی با شباهت بیشتر به کار میرود. در این روش، الگوریتم لزوماً از قبل نمیداند نام یا مفهوم هر گروه چیست؛ تفسیر نهایی خوشهها به تحلیل مسئله و دادهها نیاز دارد.
K-Means نمونههای داده را به تعداد مشخصی خوشه تقسیم میکند و مراکز خوشهها را بهصورت تکراری بهروزرسانی میکند. یکی از محدودیتهای آن این است که تعداد خوشهها معمولاً باید از قبل تعیین شود و نتیجه میتواند به مقیاس ویژگیها و شکل توزیع دادهها وابسته باشد.
در مقابل، خوشهبندی سلسلهمراتبی امکان بررسی ساختار گروهها در سطوح مختلف را فراهم میکند. الگوریتم DBSCAN نیز میتواند خوشهها را بر اساس تراکم دادهها پیدا کند و برخی نمونههای پرت را از گروهها جدا کند.
الگوریتمهای کاهش ابعاد (Dimensionality Reduction)
در بسیاری از مجموعهدادهها تعداد ویژگیها زیاد است. کاهش ابعاد با حفظ بخشی از اطلاعات مهم، داده را سادهتر میکند و میتواند برای نمایش، تحلیل یا آمادهسازی مدل مفید باشد.
یکی از روشهای شناختهشده، تحلیل مؤلفههای اصلی (PCA) است که جهتهایی را پیدا میکند که بیشترین واریانس داده در آنها قرار دارد. بااینحال، بیشترین واریانس لزوماً معادل بیشترین اهمیت برای مسئله هدف نیست؛ به همین دلیل باید اثر کاهش ابعاد بر عملکرد مدل بررسی شود.
الگوریتمهای تشخیص ناهنجاری (Anomaly Detection)
تشخیص ناهنجاری برای شناسایی نمونههایی استفاده میشود که رفتارشان با الگوی معمول داده تفاوت دارد. این روشها در کشف تراکنشهای غیرعادی، شناسایی خطاهای صنعتی و پایش رفتار سامانهها کاربرد دارند.
یک نمونه غیرعادی لزوماً تقلب یا خطا نیست؛ ممکن است رویدادی کاملاً معتبر اما کمتکرار باشد. بنابراین، خروجی الگوریتم باید در کنار قواعد کسبوکار، آستانههای تصمیمگیری و در صورت لزوم بررسی انسانی تفسیر شود.
الگوریتم های یادگیری ماشین در داده کاوی چه کاربردی دارند؟
دادهکاوی (Data Mining) فرایند کشف الگوها، روابط و اطلاعات ارزشمند از مجموعهدادههاست. الگوریتمهای یادگیری ماشین از ابزارهای مهم این فرایند هستند، اما دادهکاوی فقط به یادگیری ماشین محدود نمیشود و میتواند از روشهای آماری، تحلیل داده و دانش تخصصی حوزه نیز بهره ببرد.
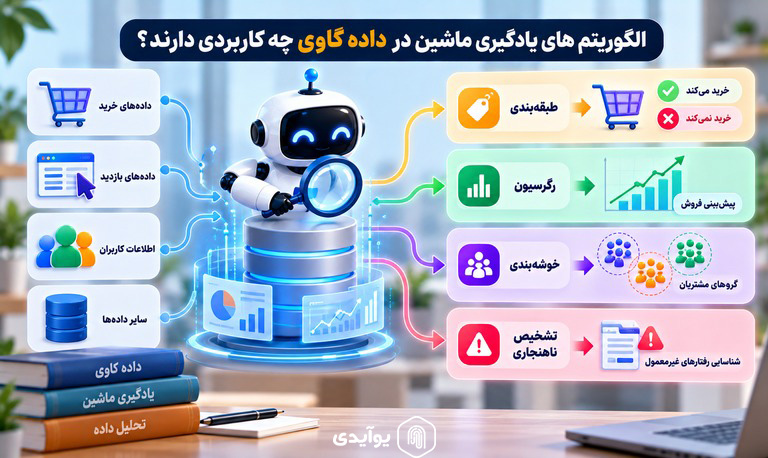
ارتباط دادهکاوی و یادگیری ماشین
فرض کنید یک فروشگاه اینترنتی میلیونها رکورد مربوط به خرید، بازدید از محصولات و رفتار کاربران در اختیار دارد. بررسی دستی همه این اطلاعات دشوار است؛ اما الگوریتمهای یادگیری ماشین میتوانند برای کشف گروههای مشتریان، پیشبینی خرید یا شناسایی رفتارهای غیرعادی به کار روند.
در این سناریو، الگوریتم بر اساس هدف انتخاب میشود:
- برای پیشبینی احتمال خرید یک محصول، ممکن است از طبقهبندی استفاده شود.
- برای تخمین فروش آینده، مدل رگرسیون کاربرد دارد.
- برای تقسیم مشتریان به گروههای مشابه، میتوان از خوشهبندی استفاده کرد.
- برای شناسایی رفتارهای غیرمعمول، روشهای تشخیص ناهنجاری میتوانند مفید باشند.
مراحل استفاده از الگوریتمهای یادگیری ماشین در دادهکاوی
یک پروژه دادهکاوی مبتنی بر یادگیری ماشین معمولاً این مسیر را دنبال میکند:
- تعریف مسئله: مشخص کنید به دنبال پیشبینی، کشف الگو، تقسیمبندی یا شناسایی ناهنجاری هستید.
- جمعآوری و شناخت داده: منابع داده را بررسی کنید و میزان کامل بودن، صحت و ارتباط آنها را بسنجید.
- پاکسازی و آمادهسازی: دادههای ناقص، ناسازگار یا تکراری را مدیریت کنید و متغیرهای مناسب را استخراج کنید.
- انتخاب روش: با توجه به هدف و نوع داده، الگوریتم یا مجموعهای از الگوریتمها را انتخاب کنید.
- آموزش و ارزیابی: مدل را آموزش دهید و کیفیت آن را روی دادههای جداگانه بسنجید.
- تفسیر نتایج: بررسی کنید الگوهای کشفشده از نظر کسبوکار یا مسئله علمی چه معنایی دارند.
- استفاده و بازبینی: نتیجه را در فرایند واقعی به کار بگیرید و در صورت تغییر دادهها، عملکرد مدل را دوباره ارزیابی کنید.
نکته مهم این است که کشف یک الگوی آماری بهتنهایی به معنای وجود رابطه علت و معلولی نیست. برای تصمیمگیری درباره علت یک رفتار یا اثر یک سیاست، ممکن است به تحلیلهای تکمیلی نیاز داشته باشیم.
کاربرد الگوریتم های یادگیری ماشین در احراز هویت دیجیتال
در فناوریهای هویتی، الگوریتمهای یادگیری ماشین میتوانند در تحلیل تصویر، استخراج اطلاعات از مدارک، تطبیق چهره و شناسایی نشانههای تقلب نقش داشته باشند. این کاربردها نیازمند طراحی دقیق، داده مناسب و ارزیابی متناسب با ریسک هستند.
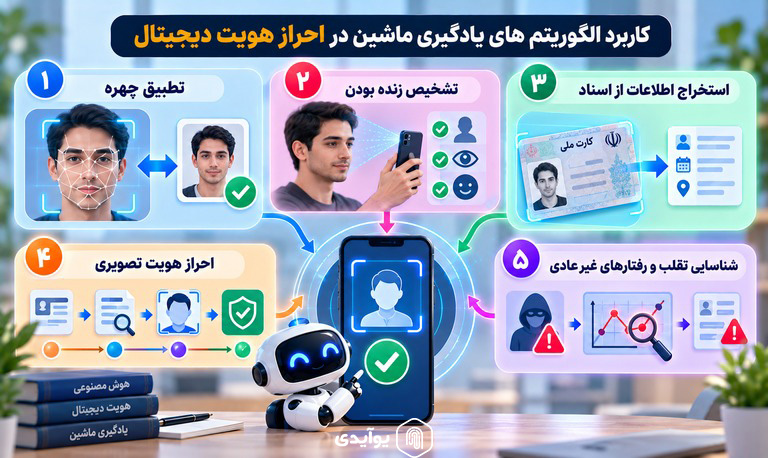
۱. تطبیق چهره (Face Verification)
در فرایند تطبیق چهره، هدف بررسی این است که آیا تصویر ارائهشده با تصویر مرجع منتسب به همان شخص مطابقت دارد یا خیر. مدل ممکن است از ویژگیهای تصویری برای تولید بازنمایی عددی چهره و اندازهگیری شباهت میان دو تصویر استفاده کند.
برای مثال، کاربر هنگام افتتاح حساب غیرحضوری یک تصویر زنده از خود ارائه میکند و سامانه آن را با تصویر مرجع مقایسه میکند. نتیجه تطبیق به کیفیت تصویر، شرایط تصویربرداری، روش مدلسازی و آستانه تصمیمگیری وابسته است.
این فرایند با شناسایی یک فرد از میان پایگاه دادهای از اشخاص متفاوت است. اگر میخواهید با جزئیات این کاربرد آشنا شوید، مقاله فناوری تشخیص چهره Face Verification مسیر مطالعه مرتبطی است.
۲. تشخیص زنده بودن (Liveness Detection)
تشخیص زنده بودن برای ارزیابی نشانههای حضور واقعی فرد و کاهش خطر حملاتی مانند استفاده از تصویر چاپی، نمایش تصویر روی صفحه یا برخی رسانههای دستکاریشده به کار میرود.
روشهای این حوزه میتوانند مبتنی بر تحلیل تصویر، توالی ویدئو، نشانههای حرکتی یا ترکیبی از روشهای مختلف باشند. برخی راهکارها نیز از مدلهای یادگیری عمیق استفاده میکنند.
بااینحال، تشخیص زنده بودن با تطبیق چهره یکسان نیست. ممکن است سامانهای زنده بودن ورودی را بررسی کند، اما همچنان لازم باشد مطمئن شود چهره متعلق به همان هویت مورد ادعاست.
برای شناخت جزئیات این بخش، مطلب فناوری تشخیص زنده بودن Liveness Detection را مطالعه کنید.
۳. استخراج اطلاعات از اسناد با فناوری OCR
فناوری تشخیص نوری نویسهها یا OCR (Optical Character Recognition) برای تبدیل تصویر حاوی متن به داده متنی قابل پردازش استفاده میشود. در سامانههای جدید، یادگیری ماشین و یادگیری عمیق میتوانند بخشهایی از فرایند تشخیص متن را پشتیبانی کنند.
برای مثال، هنگام ثبتنام آنلاین ممکن است تصویر یک مدرک هویتی دریافت شود. مدل OCR متن موجود در تصویر را استخراج میکند تا اطلاعات لازم برای مراحل بعدی پردازش شود.
اما OCR صرفاً متن را از تصویر استخراج میکند؛ بهخودیخود ثابت نمیکند که مدرک معتبر است یا شخص ارائهدهنده همان فرد ثبتشده در مدرک است. اعتبارسنجی سند، تطبیق اطلاعات و بررسی هویت مراحل جداگانهای هستند.
برای آشنایی بیشتر، مقاله فناوری OCR را مطالعه کنید.
۴. احراز هویت تصویری و تحلیل چندمرحلهای
در یک فرایند احراز هویت تصویری، ممکن است چند فناوری بهصورت مکمل استفاده شوند:
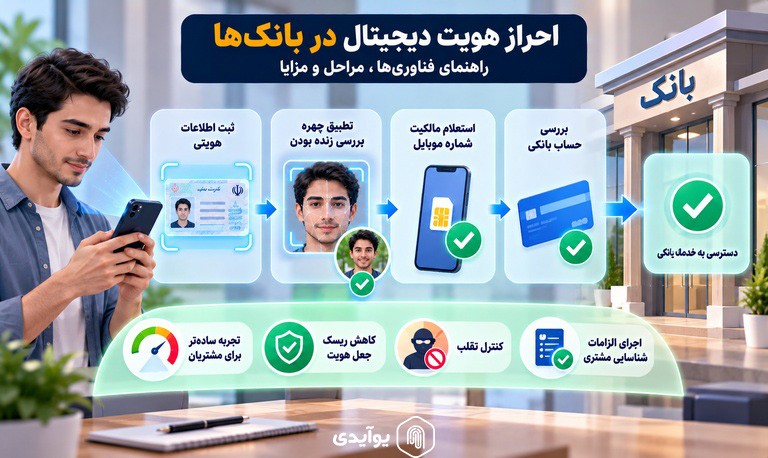
دریافت تصویر مدرک ← استخراج اطلاعات با OCR ← بررسی کیفیت و اعتبار دادهها ← دریافت تصویر یا ویدئوی کاربر ← تشخیص زنده بودن ← تطبیق چهره ← ارزیابی نتیجه و اعلام وضعیت
این مسیر یک مثال عمومی است و همه سامانهها دقیقاً از همین ترتیب استفاده نمیکنند. بعضی مراحل ممکن است در کنار یکدیگر یا در قالب یک مدل چندوظیفهای انجام شوند.
هدف این است که خروجی یک الگوریتم بهاشتباه معادل تأیید کامل هویت تلقی نشود. برای نمونه، استخراج موفق اطلاعات از کارت شناسایی با OCR بهمعنای تأیید اصالت کارت نیست.
برای آشنایی با استفاده از این فناوریها در فرایندهای هویتی، سرویس احراز هویت تصویری یوآیدی نیز مرتبط است.
۵. شناسایی تقلب و رفتارهای غیرعادی
الگوریتمهای یادگیری ماشین میتوانند نشانههایی مانند تکرار الگوهای مشکوک در ثبتنام، ناسازگاری برخی دادهها یا رفتارهای غیرعادی را بررسی کنند. این مدلها ممکن است برای اولویتبندی درخواستهای پرریسک یا کمک به بررسی انسانی به کار روند.
برای مثال، یک پلتفرم مالی میتواند بر اساس ویژگیهای مجاز تراکنش، سابقه حساب و الگوهای رفتاری، تراکنشهایی را برای بررسی بیشتر علامتگذاری کند. این خروجی بهتنهایی اثبات وقوع تقلب نیست و باید با کنترلهای دیگر ترکیب شود.
مثال عملی: انتخاب الگوریتم برای یک سامانه احراز هویت
فرض کنید یک کسبوکار میخواهد فرایند ثبتنام مشتریان را غیرحضوری کند. نیازهای فنی آن شامل استخراج اطلاعات مدرک، مقایسه چهره و شناسایی ورودیهای مشکوک است.
در چنین پروژهای، انتخاب صرفاً یک الگوریتم برای تمام وظایف معمولاً رویکرد مناسبی نیست؛ زیرا هر مرحله مسئله متفاوتی را حل میکند:
| وظیفه | رویکرد مناسب | نکته کلیدی |
| استخراج متن مدرک | OCR مبتنی بر قواعد، یادگیری ماشین یا یادگیری عمیق | کیفیت تصویر و صحت متن استخراجشده باید ارزیابی شود |
| تطبیق چهره | مدلهای بینایی ماشین و بازنمایی چهره | آستانه تطبیق و نرخ خطا اهمیت دارد |
| بررسی زنده بودن | روشهای ضدجعل و مدلهای تحلیل تصویر یا ویدئو | باید در برابر سناریوهای حمله مرتبط آزموده شود |
| کشف رفتار مشکوک | طبقهبندی یا تشخیص ناهنجاری | نتیجه مشکوک بودن، لزوماً اثبات تقلب نیست |
در چنین سامانهای، کیفیت کل فرایند به عملکرد یک مدل واحد محدود نمیشود؛ اتصال صحیح مراحل، کنترل کیفیت دادهها، امنیت زیرساخت و مدیریت خطاها نیز اهمیت دارند.
مزایا و محدودیتهای الگوریتم های یادگیری ماشین
الگوریتمهای یادگیری ماشین میتوانند تحلیل حجم زیادی از دادهها را امکانپذیر کنند، اما عملکرد موفق آنها به داده، طراحی مدل و شرایط استفاده وابسته است. شناخت محدودیتها بهاندازه شناخت قابلیتها اهمیت دارد.
مهمترین مزایای یادگیری ماشین
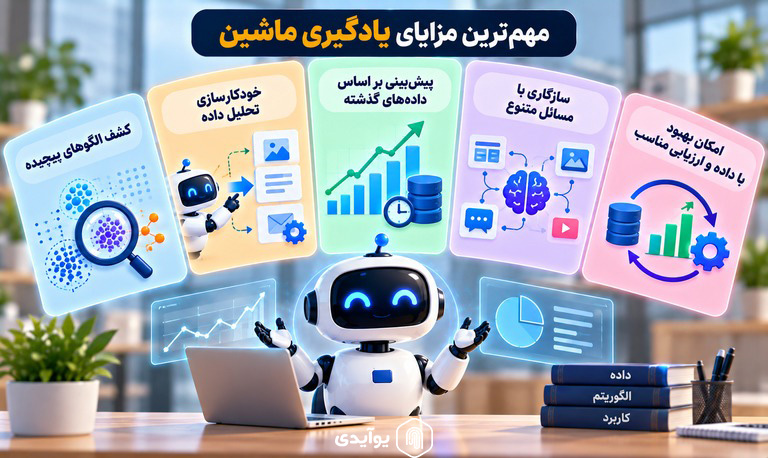
- کشف الگوهای پیچیده: برخی مدلها میتوانند روابطی را شناسایی کنند که با قواعد دستی بهسادگی قابل بیان نیستند.
- خودکارسازی تحلیل داده: وظایفی مانند دستهبندی پیامها، استخراج ویژگی از تصویر یا بررسی تراکنشها را میتوان تا حدی خودکار کرد.
- پیشبینی بر اساس دادههای گذشته: مدل میتواند با یادگیری از نمونههای قبلی، برای دادههای جدید پیشبینی انجام دهد.
- سازگاری با مسائل متنوع: از الگوریتمهای ساده برای دادههای جدولی تا شبکههای عصبی برای تصاویر و متن، روشهای متفاوتی در دسترس هستند.
- امکان بهبود با داده و ارزیابی مناسب: در صورت وجود دادههای باکیفیت و فرایند آموزش صحیح، میتوان مدل را ارزیابی و در صورت نیاز بازآموزی کرد.
محدودیتها و چالشهای یادگیری ماشین
وابستگی به کیفیت داده: دادههای ناقص، اشتباه یا نامتناسب با شرایط واقعی ممکن است باعث پیشبینیهای نامطلوب شوند.
بیشبرازش (Overfitting): زمانی رخ میدهد که مدل جزئیات و نویز دادههای آموزشی را بیش از اندازه یاد بگیرد و روی دادههای جدید عملکرد ضعیفتری داشته باشد.
سوگیری دادهها: اگر برخی گروهها در دادههای آموزشی کمتر نمایندگی شده باشند، ممکن است مدل برای آن گروهها خطاهای بیشتری داشته باشد. مدیریت سوگیری به ارزیابی، مستندسازی و بررسی مستمر نیاز دارد.
پیچیدگی تفسیر: در بعضی مدلهای پیچیده، توضیح دقیق علت هر پیشبینی دشوارتر از مدلهای سادهتر است.
هزینه محاسباتی: آموزش و اجرای برخی مدلهای عمیق به سختافزار، حافظه و زمان بیشتری نیاز دارد.
تغییر شرایط در طول زمان: اگر رفتار کاربران یا الگوی دادهها تغییر کند، کیفیت مدل ممکن است کاهش یابد. بنابراین عملکرد سیستم باید پس از استقرار نیز پایش شود.
در کاربردهای حساس مانند احراز هویت، علاوه بر دقت کلی، باید پیامد خطاهای مدل، حفاظت از اطلاعات شخصی، امکان بررسی انسانی و روش رسیدگی به اعتراض کاربران نیز در نظر گرفته شود.
چگونه الگوریتم یادگیری ماشین مناسب را انتخاب کنیم؟
انتخاب الگوریتم باید از تعریف مسئله و شناخت داده شروع شود، نه از محبوبیت یک فناوری یا پیچیدگی مدل. گاهی الگوریتم ساده و قابل تفسیر، انتخاب بهتری از یک شبکه عصبی بزرگ است.
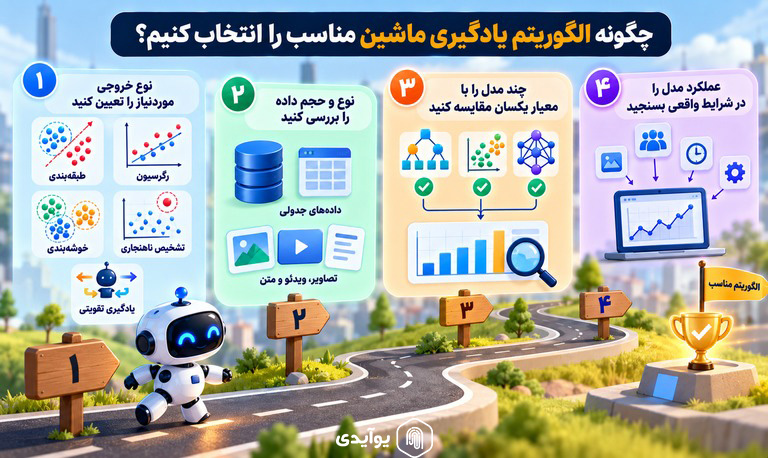
مرحله اول: نوع خروجی موردنیاز را تعیین کنید
ابتدا مشخص کنید مسئله شما در کدام دسته قرار میگیرد:
- اگر خروجی یک دسته مشخص است، مسئله طبقهبندی است.
- اگر خروجی یک مقدار عددی است، مسئله رگرسیون است.
- اگر میخواهید گروههای مشابه را پیدا کنید، به خوشهبندی نیاز دارید.
- اگر هدف یافتن رفتارهای متفاوت از الگوی معمول است، تشخیص ناهنجاری را بررسی کنید.
- اگر مسئله شامل انتخابهای متوالی و بازخورد محیط است، ممکن است یادگیری تقویتی مناسب باشد.
مرحله دوم: نوع و حجم داده را بررسی کنید
برای دادههای جدولی، الگوریتمهایی مانند رگرسیون، درخت تصمیم، جنگل تصادفی و گرادیان بوستینگ گزینههایی برای ارزیابی هستند. برای تصاویر پیچیده، شبکههای عصبی و مدلهای یادگیری عمیق میتوانند مناسب باشند. انتخاب نهایی به حجم و کیفیت داده، امکانات محاسباتی و هدف پروژه بستگی دارد.
مرحله سوم: چند مدل را با معیار یکسان مقایسه کنید
بهجای تکیه بر یک مدل، چند گزینه منطقی را با دادههای ارزیابی یکسان مقایسه کنید. انتخاب مدل باید علاوه بر کیفیت پیشبینی، هزینه اجرا، سرعت، قابلیت تفسیر و نیازمندیهای نگهداری را نیز در نظر بگیرد.
مرحله چهارم: عملکرد مدل را در شرایط واقعی بسنجید
مدلی که در محیط آزمایش عملکرد خوبی دارد، لزوماً در محیط عملیاتی همان نتیجه را ارائه نمیکند. کیفیت تصاویر، تغییر رفتار کاربران، توزیع دادهها و محدودیتهای اجرایی ممکن است نتیجه را تحت تأثیر قرار دهند.
راهنماهای فنی کتابخانه Scikit-learn نیز بر اهمیت انتخاب مدل، ارزیابی، تنظیم پارامترها و جلوگیری از خطاهای رایج در فرایند یادگیری تأکید دارند.
معیارهای ارزیابی عملکرد الگوریتم های یادگیری ماشین
دقت مدل را نمیتوان همیشه با یک معیار واحد سنجید. معیار مناسب به نوع مسئله و هزینه خطاها بستگی دارد.
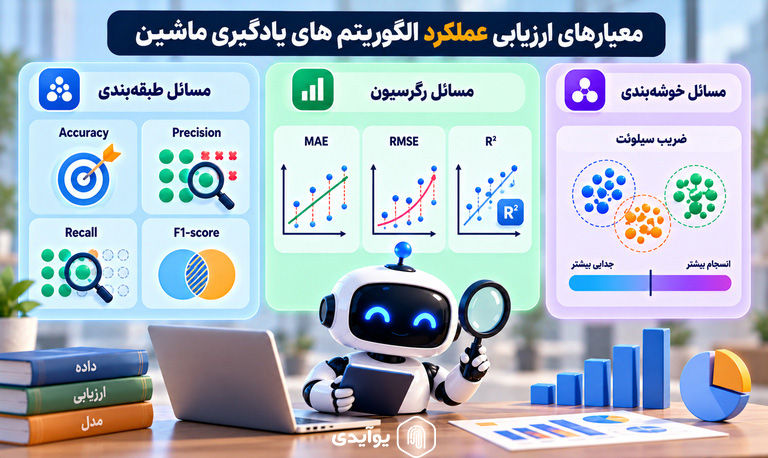
معیارهای مهم در مسائل طبقهبندی
- Accuracy (درستی کلی): سهم پیشبینیهای صحیح از کل نمونهها.
- Precision (صحت پیشبینی مثبت): از میان نمونههایی که مدل مثبت اعلام کرده، چه سهمی واقعاً مثبت بودهاند؟
- Recall (بازیابی یا حساسیت): از میان نمونههای مثبت واقعی، چه سهمی توسط مدل شناسایی شدهاند؟
- F1-score: میانگین هماهنگ Precision و Recall که برای بررسی تعادل این دو معیار کاربرد دارد.
برای مثال، در یک سامانه شناسایی تقلب، اگر تعداد موارد تقلب در مقایسه با تراکنشهای عادی بسیار کم باشد، ممکن است Accuracy بالا بهتنهایی گمراهکننده باشد. در این حالت باید معیارهای دیگر و هزینه خطاهای مثبت و منفی نیز بررسی شوند.
معیارهای مهم در رگرسیون
برای سنجش خطای پیشبینیهای عددی میتوان از معیارهایی مانند MAE، RMSE و ضریب تعیین \(R^2\) استفاده کرد. هرکدام جنبه متفاوتی از کیفیت مدل را نشان میدهند و انتخاب آنها باید با توجه به هدف پروژه انجام شود.
ارزیابی مدلهای خوشهبندی
در خوشهبندی، چون ممکن است برچسب واقعی برای گروهها وجود نداشته باشد، معیارهایی مانند ضریب سیلوئت میتوانند برای بررسی انسجام درون خوشهها و جدایی میان خوشهها استفاده شوند. بااینحال، کیفیت ریاضی خوشهها لزوماً به معنی مفید بودن آنها برای کسبوکار نیست و تفسیر کاربردی نیز اهمیت دارد.
اشتباهات رایج هنگام استفاده از الگوریتمهای یادگیری ماشین
برای ساخت یک مدل قابل اتکا، باید از چند خطای رایج پرهیز کرد.
تصور اشتباه اول: پیچیدهترین الگوریتم همیشه بهترین است
مدل پیچیدهتر الزاماً نتیجه بهتری نمیدهد. برای داده محدود یا مسئلهای که رابطه سادهای دارد، یک الگوریتم کمهزینه و قابل تفسیر ممکن است مناسبتر باشد.
تصور اشتباه دوم: Accuracy بالا یعنی مدل قابل اعتماد است
دقت کلی باید در کنار معیارهای دیگر، توزیع کلاسها و هزینه خطاها بررسی شود. بهویژه در کاربردهای هویتی و امنیتی، یک نوع خطا ممکن است پیامد بسیار متفاوتی از نوع دیگر داشته باشد.
تصور اشتباه سوم: مدل پس از آموزش دیگر به بررسی نیاز ندارد
پس از استقرار، باید عملکرد مدل و تغییرات دادهها پایش شود. افت کیفیت ممکن است به تغییر شرایط محیطی، تغییر الگوی کاربران یا تفاوت دادههای عملیاتی با دادههای آموزشی مربوط باشد.
تصور اشتباه چهارم: یادگیری ماشین علت هر الگو را مشخص میکند
مدل ممکن است رابطه آماری را کشف کند، اما این رابطه بهتنهایی اثبات نمیکند که یک ویژگی علت مستقیم نتیجه بوده است. برای نتیجهگیری علّی، به روشهای تحلیلی مناسب نیاز داریم.
تصور اشتباه پنجم: داده بیشتر همیشه نتیجه بهتر میدهد
افزایش حجم داده زمانی مفید است که دادهها به مسئله مرتبط، از کیفیت کافی برخوردار و بهدرستی جمعآوری شده باشند. داده بیشتر اما نامرتبط یا دارای خطای سیستماتیک ممکن است به بهبود عملکرد منجر نشود.
جمعبندی؛ چگونه بهترین الگوریتم یادگیری ماشین را انتخاب کنیم؟
الگوریتم های یادگیری ماشین روشهایی برای یادگیری الگو از دادهها و انجام پیشبینی یا تحلیل هستند. از یادگیری نظارتشده و بدون نظارت گرفته تا شبکههای عصبی عمیق، هر رویکرد برای مجموعهای از مسائل مناسب است و انتخاب درست به هدف، کیفیت داده، معیارهای ارزیابی، هزینه اجرا و پیامد خطاها بستگی دارد. در دادهکاوی و فناوریهای هویتی نیز معمولاً ترکیبی از روشها برای تحلیل داده، پردازش تصویر و کشف رفتارهای مشکوک به کار میرود.
برای انتخاب بهتر، ابتدا مسئله را دقیق تعریف کنید، چند مدل را با معیار مناسب ارزیابی کنید و عملکرد آنها را در شرایط واقعی بسنجید. به نظر شما کدام کاربرد یادگیری ماشین در آینده بیشترین تأثیر را بر امنیت و تجربه کاربری خواهد داشت؟ دیدگاه یا پرسش خود را در بخش نظرات بنویسید.